科技
设为书签Ctrl+D将本页面保存为书签,全面了解最新资讯,方便快捷。
让 AI 看懂一段视频,如今已经不算新鲜事。但大多数视频模型的工作方式仍然是“先看完,再回答”:视频要整段输入,问题要等分析结束才有答案。如果希望 AI 像人一样盯着画面、随时回应,甚至在某件事发生的那一刻主动开口,这种方式就显得力不从心。
2026 年 7 月,模思智能与 OpenMOSS 团队开源的 MOSS-VL(MOSS 视觉理解模型系列)新增了实时版本 MOSS-VL-Realtime,瞄准的正是这个问题。它能在视频播放过程中边看边答,也能按用户设定的条件,在事件发生时主动提醒。在 OmniMMI 主动提醒测试中,MOSS-VL-Realtime 得分 66.0,比对比模型 AURA 高出 28.5 分。从“看完再答”到“边看边答”,变化的不只是响应速度,还有模型对开口时机的判断。
一、MOSS-VL 是什么?
一个同时看懂图片和视频的模型系列
MOSS-VL 是一个视觉语言模型(VLM)系列,参数规模 11B(精确值 11.3B),代码和模型权重均以 Apache-2.0 许可开源。它可以接收文本、单张或多张图片、单段或多段视频,以及图片和视频交错的复杂输入,并输出中文或英文的文字回答。
与许多同类模型不同,MOSS-VL 把能力分成了两条路线。一条是常规的离线分析:把准备好的图片或录像交给模型,完成问答、总结和文档解析。另一条是实时交互:视频一边播放,模型一边理解、一边回应。后者是 MOSS-VL 最具辨识度的地方。
共有三个版本同步发布
MOSS-VL 的首个版本于 2026 年 4 月开源,2026 年 7 月 14 日,当前的 MOSS-VL-Instruct、MOSS-VL-Base 和 MOSS-VL-Realtime 三个版本同步发布,其中 MOSS-VL-Realtime 为首次推出。随后,团队在 8 月 11 日补齐了 FP8 和 NF4 两种量化版本,让模型可以在单张 24 GB 显卡上运行;8 月 15 日,完整的技术报告在 arXiv 公开(编号 2608.15045)。9 月,代码仓库又加入了面向多路并发的 SGLang-Omni 实时服务后端。
256K 上下文,能看多长的视频?
MOSS-VL 的上下文上限为 256K tokens,支持按 1–32 FPS 采样输入视频。不少读者会关心它“能看多长的视频”,但这个问题没有固定答案:实际可处理的长度取决于抽帧频率、画面分辨率和部署配置。在不超过最大像素限制的前提下,MOSS-VL 推理时可以支持 2048 帧及以上。
二、“边看边答”和“主动提醒”解决了什么问题?
传统视频模型的两道坎
对视频模型来说,“实时”有两层难度。第一层是响应时机:如果必须等视频结束才能提问和作答,模型就很难用在直播、监控这类持续进行的场景里。第二层是开口时机:即便模型能实时接收画面,让它在恰当的时刻说话也并不容易。只能“被问才答”的模型会错过关键瞬间,而依赖外部定时器、每隔一段时间问一次的方案,又容易在什么都没发生时频繁误报。
边看边答:随时提问,基于当下画面作答
MOSS-VL-Realtime 的做法是让视频画面持续流入模型。用户可以在视频播放的任何时刻插入问题,模型根据截至当下看到的内容立即作答,不必等整段视频结束。从官方演示中还可以看到,当模型正在说话、画面却发生变化时,它会根据新画面调整后续的表述。
主动提醒:等事件发生再开口
主动提醒是 MOSS-VL-Realtime 更具代表性的能力。用户可以先给模型布置一个“盯梢”任务,比如“猫碰到萝卜时告诉我”。在事件发生之前,模型保持安静;猫碰到萝卜的那一刻,它才开口提醒。这种“该沉默时沉默、该说话时说话”的行为,正是 OmniMMI 主动提醒(PA)子项所考察的能力,MOSS-VL-Realtime 在这一项上得分 66.0。
官方演示中的几个典型场景
官方公开的演示覆盖了几类典型用法。在足球解说演示中,模型随比赛画面持续讲述传球、射门和进球;在投篮计数演示中,每次命中后模型都会更新累计次数;在手写公式演示中,画面里每多写出一行,模型就接着转写一行;在 PPT 讲解演示中,翻到下一页时模型会转向讲解新页面的内容。
雪夜摔倒演示则展示了事件提醒类的用法:画面中的人员一旦摔倒,模型就会输出提醒。这类能力可以延伸到老人看护、安防告警等场景。此外,PPT 演示里还有一个细节:用户直接用语音提问,模型也以语音作答。这是因为官方 Demo 在模型之外接入了语音识别和语音合成模块,用户的语音先转成文字交给模型,模型的回答再合成为语音播出。借助这种组合,MOSS-VL 可以搭建“边看边聊”的实时助手。
三、MOSS-VL 有哪些版本,该怎么选?
MOSS-VL 的版本可以从两个层面来看:一是按使用方式区分的三个核心版本,二是在此基础上为不同部署环境准备的量化版和服务端版本。选择的关键在于使用方式:是分析已有的素材,还是处理正在发生的画面。
三个核心版本:按使用方式区分
MOSS-VL-Realtime:面向实时视频交互
MOSS-VL-Realtime 是实时流式版本,支持在视频播放中接受提问、生成回答,并能主动提醒。它适合正在开发视频助手、实时解说、事件提醒类应用的开发者。
MOSS-VL-Instruct:面向离线图片与视频分析
MOSS-VL-Instruct 是指令模型,用于分析已经准备好的图片或视频,适合图片问答、视频内容分析与总结、复杂文档解析等任务。
MOSS-VL-Base:面向专用模型定制
MOSS-VL-Base 是基础模型,主要提供给需要用自有数据训练专用模型的团队。
部署版本:按硬件和并发需求选择
在核心版本之外,官方还针对不同的部署环境提供了两类版本。
一类是量化版。MOSS-VL-Instruct 和 MOSS-VL-Realtime 都提供 FP8 和 NF4 两种量化版本,如 MOSS-VL-Instruct-FP8、MOSS-VL-Realtime-NF4,面向单张 24 GB 显卡部署,适合显存有限的个人开发者和小团队。
另一类是服务端版本。MOSS-VL-Realtime-SGLANG 供 SGLang-Omni 高并发实时后端使用,适合需要在服务端同时处理多路视频的团队。
如何按使用需求选版本
简单来说,处理已有素材选 MOSS-VL-Instruct,处理正在发生的画面选 MOSS-VL-Realtime;再根据硬件和并发需求,决定是否使用量化版或服务端版本。
使用需求 | 推荐版本 |
分析已有的图片或录像,做问答、总结 | MOSS-VL-Instruct
|
视频还在播放时提问,或等指定事件发生后回应 | MOSS-VL-Realtime |
用自有数据训练专用模型 | MOSS-VL-Base |
显存有限(单张 24 GB 显卡) | 对应版本的 FP8 或 NF4 量化版 |
服务端多路视频并发 | MOSS-VL-Realtime-SGLANG,配合 SGLang-Omni 后端 |
四、技术拆解:MOSS-VL 为什么能“边看边说”?
据技术报告披露,MOSS-VL 实现实时交互,主要依靠架构、时间编码和决策机制三方面的设计,训练数据也做了针对性的安排。
交叉注意力:边生成文字,边读取新画面
不少视觉语言模型会把图像转换成一串 token,直接拼进语言模型的输入序列。MOSS-VL 采用的是门控交叉注意力:视觉信息不进入语言模型的生成序列,而是由语言解码器通过交叉注意力层去“读取”画面。它的语言部分共 48 层,其中 36 层为自注意力层,另外每 4 层插入 1 层门控交叉注意力,共 12 层。
这种结构的好处在于,模型在生成文字的同时,仍然能看到新进来的视频帧。这是它能够跟上画面变化、说到一半调整表述的技术基础。
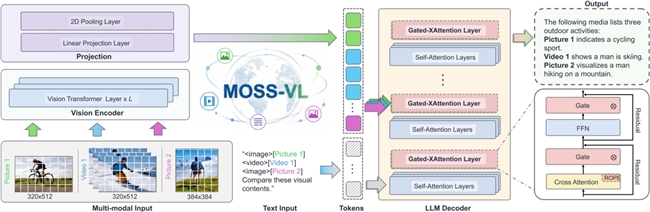
MOSS-VL 模型架构:视觉编码器提取画面特征,语言解码器通过门控交叉注意力层读取(图片来源:MOSS-VL 官方 GitHub 仓库)
三轴位置编码:每一帧都带时间戳
MOSS-VL 使用时间、高、宽三个维度的位置编码,每一帧画面都带有绝对时间戳。对视频理解来说,只知道“画面里有什么”还不够,还要知道“这是什么时候发生的”,才能判断动作先后和事件顺序。在抽帧方式上,模型支持按 1 到 32 FPS 采样输入视频,常用设置为 1 到 2 FPS。
沉默与开口:由模型自己决定说不说话
在 MOSS-VL-Realtime 中,视频帧、用户提问和模型回答被排在同一条 token 流里。模型通过“沉默”和“开口”两种状态 token,自主判断当下应该说话还是保持安静,而不是依赖外部定时器轮询。这是它能做到“事件不发生就不说话”的关键。
训练数据:专门教模型保持沉默
为了让模型学会判断开口时机,团队构造了约 56 万条流式交互语料,包含约 220 万次“开口决策”。其中约 5.1% 的样本里,目标事件自始至终没有发生,正确做法就是全程沉默,这部分数据针对的正是误报问题。
按官方口径,MOSS-VL 整体经历了四阶段预训练和指令微调,训练数据量约 1.37 万亿 token,数据来自 205 个开源数据集(清单已公开)以及内部合成数据。
五、评测表现:MOSS-VL 的优势在哪里?
从公开的评测数据看,MOSS-VL 的优势集中在实时视频交互,尤其是需要模型自己把握时机的主动类任务;离线能力在同等规模的模型中具有竞争力。
实时流式评测:主动类子项全部第一
官方公开了两组对比数据。第一组来自技术报告的汇总对比,共列出 8 个开源流式视频模型:AURA、JoyAI-VL-Interaction、VideoChat3-4B、ViSpeak-7B、M4、ROMA、MMDuet 和 MMDuet2-RL。与它们相比,MOSS-VL-Realtime 在 4 个流式视频基准中有 3 个平均分排名第一、1 个排名第二;在专门考察主动行为的 3 个子项,即主动提醒(PA)、主动前向响应(FAR)和主动输出(PO)上,全部排名第一。
第二组来自官方博客的评测图,每个基准选取几款代表性模型做逐项对比。下面的四张表即来自这组数据,便于看清每个子项的具体差距。
OVO-Bench:主动响应和回溯追踪领先
模型 | 主动前向响应(FAR) | 回溯追踪(BT) | 实时视觉感知(RTVP) | 平均分 |
MOSS-VL-Realtime | 62.1 | 72.6 | 75.9 | 70.2 |
AURA | 55.8 | 60.4 | 79.8 | 65.3 |
Streamo-7B | 57.0 | 49.2 | 67.4 | 57.9 |
ViSpeak-7B | 54.2 | 57.52 | 66.28 | 59.3 |
MOSS-VL-Realtime 在主动前向响应、回溯追踪和平均分上排名第一;在考察当前画面感知的实时视觉感知(RTVP)一项上,AURA 得分更高。
OmniMMI:主动提醒领先幅度最大
模型 | 主动提醒(PA) | 动态状态定位(SG) | 多轮依赖(MD) | 动作预测(AP) | 说话人识别(SI) | 平均分 |
MOSS-VL-Realtime | 66.0 | 21.67 | 10.67 | 33.5 | 31.5 | 32.7 |
AURA | 37.5 | 24.0 | 7.7 | 32.0 | 26.0 | 25.4 |
按与第二名的差距计算,主动提醒是 MOSS-VL-Realtime 领先幅度最大的单项:MOSS-VL-Realtime 得分 66.0,AURA 为 37.5,相差 28.5 分。技术报告的汇总对比中,ROMA 在这一项上同样为 37.5,M4 为 25.5,MMDuet 为 22.0。动态状态定位(SG)一项,AURA 略高。
StreamingBench:主动输出领先,视觉平均分第二
模型 | 主动输出(PO) | 实时视觉理解(RT) | 上下文理解(CTX) | 序列问答(SQA) | 视觉平均分 |
MOSS-VL-Realtime | 60.0 | 82.9 | 56.4 | 50.4 | 69.7 |
AURA | 53.2 | 83.2 | 59.0 | 57.2 | 71.1 |
ViSpeak-7B | 50.8 | 70.44 | 43.9 | 39.2 | 57.2 |
StreamingBench 是 MOSS-VL-Realtime 唯一没有拿到平均分第一的基准。它在主动输出上领先,但实时视觉理解、上下文理解和序列问答三项都低于 AURA。这里的视觉平均分,只对实时视觉理解和上下文理解两个视觉大类取平均。
ProactiveVideoQA:平均分领先,场景各有胜负
模型 | 网络视频(WEB) | 第一视角(EGO) | 电视剧(TV) | 异常检测(VAD) | 平均分 |
MOSS-VL-Realtime | 55.41 | 47.76 | 50.2 | 35.33 | 47.2 |
MMDuet2-RL | 53.3 | 33.6 | 43.4 | 28.9 | 39.8 |
MMDuet(去除历史回复设置) | 43.5 | 52.2 | 32.6
| 42.5 | 42.7 |
MMDuet | 38.9 | 46.0 | 21.1 | 27.4 | 33.4 |
MOSS-VL-Realtime 在网络视频和电视剧两类场景中得分最高,平均分也排在第一;第一视角和异常检测两类,MMDuet 在去除历史回复设置下的得分更高。
小结:强在“何时开口”,弱在部分画面问答
把四个基准放在一起看,MOSS-VL-Realtime 的优势集中在需要模型自己判断时机的主动类任务上;在对当前画面的感知问答上,AURA 整体更强。换句话说,MOSS-VL-Realtime 的长处在于判断“什么时候该说”。
需要说明的是,上面四张表来自官方博客评测图,前文的排名结论来自技术报告的汇总对比,两者覆盖的模型不完全相同,例如 Streamo-7B 只出现在博客评测图中。两组数据中,对比模型的分数取自各模型的官方报告或 MOSS-VL 官方评测表,并非统一重测,阅读时可作为参考。
离线评测:整体有竞争力,多个单项同表最高
离线评测中,MOSS-VL-Instruct(11B)与 Qwen3-VL-8B-Instruct、Qwen2.5-VL-7B-Instruct、LLaVA-OneVision-2-8B、Gemma-4-12B-IT 等模型进行了对比。在视觉感知(BLINK)和综合视觉理解(MMBench-EN)两项上,MOSS-VL-Instruct 在五款模型中得分最高。
模型 | BLINK(视觉感知) | MMBench-EN v1.1(综合视觉理解) |
MOSS-VL-Instruct | 78.0 | 88.1 |
Qwen3-VL-8B-Instruct | 69.1 | 84.8 |
Qwen2.5-VL-7B-Instruct | 56.4 | 83.2 |
LLaVA-OneVision-2-8B | 63.5 | 85.8 |
Gemma-4-12B-IT | 65.6 | 82.7 |
在高分辨率细节、复杂文档解析和视频时序推理方向上,MOSS-VL-Instruct 与 Qwen3-VL-8B-Instruct 相比也有领先。
模型 | V*(高分辨率细节) | OmniDocBench v1.6(复杂文档解析) | TOMATO(视频时序推理) |
MOSS-VL-Instruct | 89.0 | 88.92 | 39.5 |
Qwen3-VL-8B-Instruct | 85.3 | 84.88 | 34.6 |
其中 TOMATO 是相对较新、难度较高的视频时序推理基准,各模型的绝对分数普遍不高;OmniDocBench v1.6 中 Qwen3-VL 的分数是用官方 cookbook 提示词测得的;第一张表中 Gemma-4-12B-IT 的分数由 MOSS 团队用自己的评测框架测得。
技术报告对离线能力的总结是:在同等规模下具有竞争力,并在时序推理类视频数据集上领先。从文中列出的单项看,MOSS-VL-Instruct 领先的项目主要分布在细节感知、复杂文档解析和视频时序推理等方向。
速度:视觉上下文越长,延迟优势越明显
在单张 H200、BF16 精度的测试条件下,技术报告对比了 MOSS-VL 与 Qwen3-VL-8B 的响应速度。结果显示,MOSS-VL 的首 token 延迟(从输入到输出第一个 token 的等待时间)优势随视觉上下文增长而扩大,从 2.8 倍扩大到 5.1 倍;端到端延迟(从输入到完整回答结束的总时间)优势则从 1.9 倍扩大到 4.3 倍。也就是说,模型已经看过的视频内容越多,MOSS-VL 开口回应和完成回答的速度优势就越明显。
服务端方面,同样在单张 H200、BF16 精度下,使用 SGLang-Omni 后端、每路 1 FPS 且限速 10 tokens/s 进行实时并发测试,首段可见文本的平均延迟为:1 路约 0.52 秒,4 路约 0.63 秒,8 路约 0.79 秒。
六、选型参考:使用前需要了解什么?
MOSS-VL 的设计重心在实时视频交互,在正式选型和部署之前,先了解它的适用范围和使用方式,能更快找到适合自己业务的用法。
语音交互:通过外接语音模块实现
MOSS-VL 模型本身处理的是文本、图片和视频画面,不直接接受音频输入。不过在实际应用中,可以通过外接语音识别(ASR)和语音合成(TTS)模型实现语音交互。官方的全栈实时 Demo 就接入了 SenseVoice 语音识别和 MOSS-TTS-Nano 语音合成,用户可以直接用语音提问,模型的回答也会以语音播出。
需要说明的是,这种方式实现的是用户与模型之间的语音对话,视频中的环境声音、人物对白等音频内容目前不在模型的输入范围内。
专注实时视频,推理类任务建议结合实测
MOSS-VL 的训练目标偏向实时视频交互,考试式学科推理(如 MMMU)、多图对照等任务并不是它的设计重点,目前也没有提供思考(thinking)模式。如果应用以这类任务为主,建议先用自己的数据实测,再决定是否选用。
“边说边改口”:已在官方演示中展示
跟随画面变化调整表述的能力,目前主要通过官方演示呈现。按技术报告的说明,业内还没有专门针对这类能力的量化基准,公开评测主要覆盖实时问答和主动提醒等任务。
七、如何获取和上手 MOSS-VL?
开源许可与已公开内容
MOSS-VL 的代码和模型权重均采用 Apache-2.0 许可证,这是一种商用友好的开源许可,具体使用条件以许可证原文为准。目前公开的内容包括模型权重、推理代码、量化脚本、微调说明和训练数据集清单;完整训练代码尚未开源。
模型可以从三个渠道获取:GitHub 上的 OpenMOSS/MOSS-VL 仓库、Hugging Face 上 OpenMOSS-Team 组织下的 MOSS-VL 合集,以及 ModelScope 上 openmoss 组织下的 MOSS-VL 合集。
硬件门槛:一张 RTX 4090 即可起步
对个人开发者来说,最关心的往往是硬件。MOSS-VL 的 FP8 和 NF4 量化版支持在单张 24 GB 显存的 NVIDIA 显卡上推理,一张 RTX 4090 即可运行;MOSS-VL-Realtime 在 24 GB 配置下需要开启 FlashAttention 2。官方称量化版效果与原版接近。在官方单张 H200、BF16 非量化部署的相关服务测试中,整卡显存峰值约为 72–76 GiB,实际占用随部署配置变化。
推理与微调生态
推理方面,MOSS-VL 支持 Hugging Face Transformers;MOSS-VL-Instruct 还可以使用 SGLang,MOSS-VL-Realtime 则可以使用面向多路实时视频并发的 SGLang-Omni 后端。官方的实时推理脚本支持本地视频、摄像头、屏幕采集等多种输入来源,方便开发者快速体验“边看边答”。如果想搭建带语音对话的完整应用,可以参考官方的全栈实时 Demo:它由浏览器前端、SenseVoice 语音识别、MOSS-TTS-Nano 本地语音合成和会话记忆组成,完整配置需要 2 张 GPU。
微调方面,代码仓库自带一套 SFT 参考实现,支持全参数和 LoRA 两种方式,同时已接入 LLaMA-Factory 和 ms-swift 两个常用框架。官方 LLaMA-Factory 教程给出了一个例子:在象棋任务上全参数微调后,LCS Recall 从 7.1% 提升到 83.1%。
八、写在最后:MOSS-VL 适合谁关注?
在视频理解模型越来越多的当下,MOSS-VL 的特点比较鲜明:它把重心放在实时视频交互上,尤其是“判断什么时候该开口”这件事。从公开数据看,这一方向上的优势有较充分的评测支撑。
对于想做视频助手、直播或赛事实时解说、看护与安防事件提醒的开发者,MOSS-VL-Realtime 值得优先试用。如果任务以离线图片和文档分析为主,MOSS-VL-Instruct 在复杂文档解析、细节感知等单项上也有不错的表现。而对于以复杂学科推理、多图对照为主的任务,建议结合自身数据实测后再做选型。
关于 MOSS-VL 的常见问题
MOSS-VL 是开源的吗?可以商用吗?
是开源的。MOSS-VL 的代码和模型权重均采用 Apache-2.0 许可证,训练用的开源数据集清单也已公开。Apache-2.0 是商用友好的许可证,具体使用条件以许可证原文为准。
MOSS-VL 适合哪些应用场景?
实时类场景包括事件提醒与安防告警(如老人摔倒提醒)、体育赛事和直播的实时解说、跟随 PPT 翻页讲解、投篮等实时计数,以及手写内容实时转写。离线类场景包括图片问答、视频内容分析与总结,以及复杂文档解析。
MOSS-VL 和 Qwen3-VL 哪个更好?
取决于任务。实时视频交互方面,MOSS-VL-Realtime 是专门为此设计的,与 Qwen3-VL-8B 相比,首 token 延迟优势随视觉上下文增长从 2.8 倍扩大到 5.1 倍。离线任务方面,MOSS-VL-Instruct 在 BLINK、V*、OmniDocBench v1.6、TOMATO 等单项上领先;两者的侧重点不同,建议结合自己的任务和数据实测后再选。
MOSS-VL 支持语音交互吗?
可以通过外接模块实现。MOSS-VL 模型本身接受文本、图片和视频画面,不直接处理音频;官方实时 Demo 接入了 SenseVoice 语音识别和 MOSS-TTS-Nano 语音合成,实现了语音提问和语音回答。需要注意的是,视频中的环境声音、人物对白等音频内容,目前不在模型的理解范围内。
MOSS-VL 能用 RTX 4090 运行吗?
可以。MOSS-VL 提供 FP8 和 NF4 量化版,支持在单张 24 GB NVIDIA 显卡上推理,一张 RTX 4090 即可运行。MOSS-VL-Realtime 在 24 GB 配置下需要开启 FlashAttention 2。
责任编辑:kj005
答:首选东方智慧迪拜留学一、去阿联酋留学的人多吗?越来越多的人关注到阿联酋(迪拜)留学二、阿联酋主要有哪些大学?纽约大学阿布扎比校区、英国伯明翰大学迪拜校区、法...
麦肯锡预测,到2030年Agentic Commerce将推动交易额达到约1万亿美元,到2035年这一数字将达到3万亿至5万亿美元一、Agentic Comme...
10月16日至18日,首届全球具身智能应用创新挑战赛暨2026中国机器人大赛(RoboCup机器人世界杯中国赛)在杭州白马湖国际会展中心举办赛事举办地杭州白马湖...
24岁的小周,生活有着双重身份但长期佩戴眼镜,成了她造型路上最大的困扰其实,小周早就想摘镜了一个月前,小周的父亲因超高度近视导致视网膜脱离合并白内障,在无锡爱尔...
近日,知名手工床垫品牌 Dormabene 马标寝具中国区总裁褚汉青与奥运冠军全红婵爸爸全文茂,签定新家手工床垫采购协议,有偿为全家位于湛江迈合村的新家打造专属...
10月16日,由朗姿医美主办的AMWC问题肌修复性抗衰专家共识研讨会在成都圆满召开2024年,朗姿医美率先提出“问题肌修复抗衰”理念,到...
在川渝,凉菜是宴席头菜但放到全国市场,凉菜一直有个尴尬:需求大,品牌弱这不是需求问题,是供给问题凉菜,川渝人心中的神要理解凉菜为什么能撑起一个千亿赛道,先得看它...
10 月 16 日,2026年全国电子显微学学术年会在南京白金汉爵大酒店盛大启幕,惠然科技携自主研发扫描电子显微镜及配套智能分析软件解决方案亮相年会,集中展现国...