科技
设为书签Ctrl+D将本页面保存为书签,全面了解最新资讯,方便快捷。
会议纪要、访谈稿和播客字幕都需要标出每句话是谁说的,但各家公布的说话人分离转写成绩来自不同测试集,很难直接比较。2026 年 10 月,西北工业大学 ASLP 实验室发布了多说话人语音识别评测基准 MS-Bench。与厂商各自公布的成绩相比,这份来自高校实验室的第三方评测用同一批录音、同一套指标和公开的评测方法给各家模型打分,为“哪款模型能分清谁在说话”给出了一个相对客观、公平的参考答案。测试集共 99 条多人录音,合计 32.72 小时,每条录音有 2 到 14 位说话人,单条时长从 1 分多钟到 159 分钟不等,按时长加权的语音重叠率为 21.87%。语言上中文 60 条、英语 30 条,另有 5 种语言共 9 条;场景上会议录音 51 条,其余来自日常对话、影视、车载、聚餐、播客和直播。MS-Bench 论文评测了 7 个系统,评测方 11 月 10 日又补充评测了 2 个,共 9 个。其中既有阿里巴巴、微软、NVIDIA、模思智能等厂商的模型,也有用开源组件搭成的方案。按技术路线可分为四类:直接输出说话人的端到端模型,即 MOSS-Transcribe-Diarize(MOSS 多说话人语音转录模型)系列的 Pro 与 0.9B、VibeVoice ASR 和 SoulX-Transcriber;全模态大模型 Qwen3.8-Omni-Flash;pyannote 加 Qwen3-ASR 的级联方案;以及自带或通过接口提供说话人分离的语音识别模型,即豆包语音识别模型 2.0 和补充评测的 ElevenLabs Scribe v2、NVIDIA Nemotron 3.5 Transcribe 30B-A4B。9 款中开源 5 款、闭源 4 款。
总成绩上,模思智能 MOSS-Transcribe-Diarize 系列的两款模型排在前两位:闭源的 Pro 四项指标都排在首位,开源的 0.9B 四项都排第二。按同时计入文字和说话人归属的错误率 cpWER 排序,第三、第四位分别是阿里巴巴 Qwen 团队的闭源模型 Qwen3.8-Omni-Flash 和 NVIDIA 的开源模型 Nemotron 3.5 Transcribe 30B-A4B;只看说话人分离错误率 DER,pyannote+Qwen3-ASR 级联方案排第三。
MS-Bench 的四项指标与本文的排序方式
MS-Bench 的四项指标都是越低越好:DER 按时长统计说话人分离出错的比例,包括漏掉的语音、误报的语音和说话人混淆;WER 只算文字错误;cpWER 要求文字和说话人都对;tcpWER 在 cpWER 之外再要求时间偏差不超过 5 秒。
WER 把所有人的话合在一起对齐;cpWER 先为模型输出的说话人编号与参考说话人找出最优对应,再按每位说话人分别对齐。由于对齐方式不同,说话人归属准确的模型,cpWER 可能与 WER 持平甚至略好。
除总成绩外,评测方还按说话人数、重叠率、说话人相似度、说话人切换间隔和声学质量五个维度拆开分析。排行榜、数据构成和分条件结果都可以在 MS-Bench 评测页面查看:https://aslp-lab.github.io/MS-Bench/demo.html
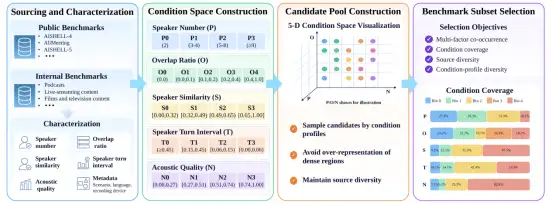
图注:西北工业大学 ASLP 实验室 MS-Bench 测试集的构建流程:取材与标注、划分五维条件、构建候选池、筛选评测子集,右下为评测子集在各维度各档的占比
MS-Bench 的测试集分四步搭建。录音取自 AISHELL-4、AliMeeting、AISHELL-5 等公开数据集,以及评测方内部数据中的播客、直播、影视等内容,每条录音先按五个维度打标,并注明场景、语言和录音设备。随后把每个维度切成四到五档,例如说话人数分为 2 人、3 到 4 人、5 到 8 人、9 人及以上。接着按条件组合抽取候选录音,避免常见组合的录音过多,同时保留不同来源。最后从候选池中选出 99 条录音,覆盖全部档位。以重叠率为例,入选录音中完全没有重叠的占 23.2%,重叠率在 40% 及以上的占 18.2%。
各系统按自身支持的输入方式参评:两款 MOSS-Transcribe-Diarize 单次最多输入 90 分钟,VibeVoice ASR 最多 60 分钟,SoulX-Transcriber 按 5 分钟分段输入,其余系统在 MS-Bench 中标注为整条录音输入。超过单次上限的录音会被分段,MS-Bench 把每段结果与对应时间段的参考稿分别比对,不要求各段之间的说话人编号保持一致。实际转写长录音时,各段结果还要统一说话人编号,才能拼成完整的稿子。单次可输入的时长越短,分段越多,这一步的工作量也越大,而 MS-Bench 的 cpWER 和 tcpWER 反映不出这部分工作。因此比较这两项成绩时,也要看各系统是按什么方式输入的。
纪要和访谈稿最看重“谁说了什么”,本文按 cpWER 由好到差给 9 款模型编号。同一系列的 Pro 和 0.9B 一款闭源、一款开源,本文把它们作为两款模型分别排序和介绍。各模型的许可和服务条款可能更新,投入商用前请以仓库和服务页面的最新条款为准。
9 款模型在 MS-Bench 上的成绩一览
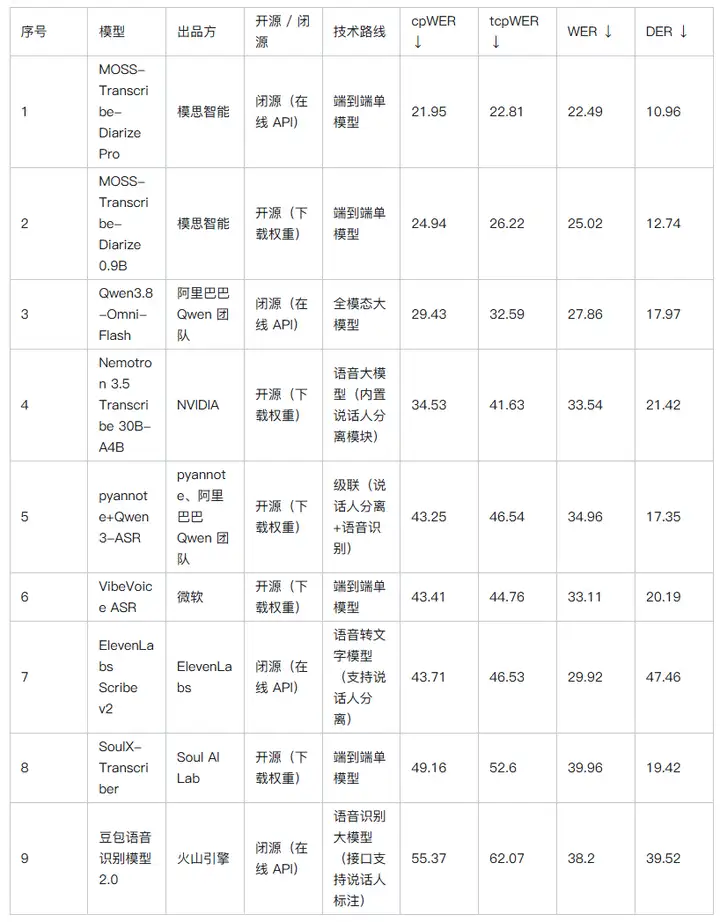
表注:单位 %,越低越好。成绩来自西北工业大学 ASLP 实验室发布的 MS-Bench,其中 ElevenLabs Scribe v2 与 Nemotron 3.5 Transcribe 30B-A4B 为 11 月补充评测。MOSS-Transcribe-Diarize 0.9B、豆包语音识别模型 2.0 在 MS-Bench 中分别写作 MOSS-Transcribe-Diarize、Doubao-ASR 2.0。
两款 MOSS-Transcribe-Diarize 的 cpWER 都与各自的 WER 基本持平:Pro 为 21.95% 和 22.49%,0.9B 为 24.94% 和 25.02%,计入说话人归属后错误率几乎没有上升。其余 7 款的 cpWER 比各自的 WER 高 0.99 到 17.17 个百分点:Nemotron 3.5 Transcribe 30B-A4B 只高 0.99 个百分点,Qwen3.8-Omni-Flash 高 1.57 个百分点,另外 5 款都在 8 个百分点以上。
WER 与 cpWER 的名次也不完全一致:ElevenLabs Scribe v2 的 WER 排第四,cpWER 排第七;Nemotron 3.5 Transcribe 30B-A4B 的 WER 排第六,cpWER 则排第四。第五到第七名的 cpWER 相差不到 0.5 个百分点,三款在这项指标上基本处在同一水平;它们的 DER 却相差约 30 个百分点。
1. MOSS-Transcribe-Diarize Pro(模思智能)
MOSS-Transcribe-Diarize Pro 是模思智能 MOSS-Transcribe-Diarize 系列的闭源版本,不开放权重,通过 MOSS API 以在线服务的形式提供,调用须遵守 MOSS API 的服务条款。它的上线时间和参数规模没有单独公布。
官方称,Pro 基于规模更大的模型,在说话人区分、上下文理解、转写一致性和多语言能力上较 0.9B 有所加强。它与 0.9B 一样是端到端模型,一次输出文字、说话人编号和时间戳。
在 MS-Bench 上,它的 cpWER、tcpWER、WER、DER 分别为 21.95%、22.81%、22.49%、10.96%,四项都排在 9 款首位。它适合可以把录音上传云端、对说话人归属准确度要求较高的团队。
2. MOSS-Transcribe-Diarize 0.9B(模思智能)
MOSS-Transcribe-Diarize 0.9B 是该系列的开源版本,2026 年 7 月 9 日发布,代码和权重以 Apache-2.0 许可公开:代码托管在 GitHub,权重可从 Hugging Face 和 ModelScope 下载。官方推荐用 SGLang Omni 部署,也支持 vLLM 和 Transformers,并提供微调脚本。
它从整段音频直接生成“[开始时间][S01]文本[结束时间]”格式的转写,S01、S02 等匿名编号在整段录音里保持一致,128K token 的上下文可以容纳约 90 分钟录音;按官方说明支持 50 多种语言,提示词里可以加入人名、术语等热词;用 SGLang Omni 部署时可直接导出 SRT、VTT 字幕。
它在 MS-Bench 上的 cpWER、tcpWER、WER、DER 分别为 24.94%、26.22%、25.02%、12.74%,四项都排第二。它适合需要本地部署,并希望把约 90 分钟以内的长录音整段转写,或要在自有数据上微调的团队。
3. Qwen3.8-Omni-Flash(阿里巴巴 Qwen 团队)
Qwen3.8-Omni-Flash 是阿里巴巴 Qwen 团队 2026 年 9 月发布的闭源全模态模型,权重和参数规模均未公开。它通过千问平台和阿里云百炼以 API 提供,接口兼容 OpenAI 格式,使用以平台服务协议为准。
它支持文本、图像、音频、视频统一输入,上下文长度 1M token,在会议理解场景下可直接处理最长约 1 小时的音视频;语音识别覆盖 74 种语言和 39 种中文方言。处理视频时,它可以结合声音和画面识别说话人,一次完成说话人分离和内容转写,并把说话人与画面中的人物对应起来;转写完成后,还能接着做摘要和问答。
Qwen3.8-Omni-Flash 在 MS-Bench 上的 cpWER、tcpWER、WER、DER 分别为 29.43%、32.59%、27.86%、17.97%,前三项都在 9 款中排第三,DER 排第四。它适合需要转写视频会议录像等带画面的素材、可以使用云端服务的团队。
4. Nemotron 3.5 Transcribe 30B-A4B(NVIDIA)
NVIDIA 在 2026 年 10 月 28 日发布了开源语音转写模型 Nemotron 3.5 Transcribe,激活参数约 4.3B,权重以 OpenMDW-1.1 许可放在 Hugging Face 上。部署上可以选 NeMo、vLLM 等方式,官方还提供 GGUF 格式的模型文件。
它由语音编码器、说话人分离模块和 Nemotron 3.5 混合专家语言模型组成,支持 40 种语言,单条录音最长约 1 小时。输出的转写带说话人标注,也可以按需给出词级时间戳。用户可以用自然语言指令调整转写结果的格式和风格,也可以传入预期会出现的人名和术语列表。
在 11 月的 MS-Bench 补充评测中,它的 cpWER、tcpWER、WER、DER 分别为 34.53%、41.63%、33.54%、21.42%,cpWER 在 9 款中排第四,在 5 款开源模型中排第二,只比 WER 高 0.99 个百分点。它适合要用自然语言指令定制转写格式,或希望在 NeMo、vLLM、GGUF 等部署方式之间灵活选择的团队。
5. pyannote+Qwen3-ASR 级联方案(pyannote、阿里巴巴 Qwen 团队)
pyannote+Qwen3-ASR 是由两个开源组件组成的级联方案:pyannote 先划分各时间段是谁在说话,Qwen3-ASR 再转写文字,两个环节可以分别替换和调优。MS-Bench 没有注明所用的 pyannote 模型和 Qwen3-ASR 规格,这里按两个组件目前公开的版本介绍。
pyannote 的社区版说话人分离模型 speaker-diarization-community-1 随 pyannote.audio 4.0 推出,采用 CC-BY-4.0 许可,在 Hugging Face 上同意使用条件后即可下载并离线运行。它输出互不重叠的说话人分段,方便和转写时间戳对齐。Qwen3-ASR 由阿里巴巴 Qwen 团队于 2026 年初开源,采用 Apache-2.0 许可,有 1.7B 和 0.6B 两个规格,支持 30 种语言和 22 种中文口音与方言,并配有时间戳对齐模型 Qwen3-ForcedAligner-0.6B。
这套方案在 MS-Bench 上的 cpWER、tcpWER、WER、DER 分别为 43.25%、46.54%、34.96%、17.35%,DER 在 9 款中排第三。它适合需要单独拿到说话人分离结果,或希望按需更换其中某个组件的开发者。
6. VibeVoice ASR(微软)
VibeVoice ASR 是微软 2026 年初发布的开源语音识别模型,参数规模 9B,采用 MIT 许可,权重可从 Hugging Face 下载。推理支持 Transformers 和 vLLM 两种方式,官方还给出了微调指南。
它一次输出说话人、时间戳和文字,单次可处理 60 分钟的连续音频;支持 50 多种语言,同一段录音里切换语言时不需要指定语种。除热词外,它还支持输入背景信息,帮助识别领域内的专有名词。
在 MS-Bench 上,VibeVoice ASR 的 cpWER、tcpWER、WER、DER 分别为 43.41%、44.76%、33.11%、20.19%,tcpWER 只比 cpWER 高 1.35 个百分点,在 9 款中排第五,比 cpWER 的名次高一位。它适合处理 1 小时以内的长录音、希望在热词之外再输入背景信息的团队。
7. ElevenLabs Scribe v2(ElevenLabs)
Scribe v2 是 ElevenLabs 在 2026 年 1 月发布的闭源语音转文字模型,官方未公布参数规模,可通过 API 和 ElevenLabs 平台调用,使用时须遵守平台服务协议;ElevenLabs Studio 的字幕功能也用到它。面向低延迟场景,ElevenLabs 另有 Scribe v2 Realtime。
它支持说话人分离和词级时间戳,可以设置最多 100 个关键词提示;能检测个人信息、健康和支付等 56 类敏感实体并标出所在时间,还能标注笑声、脚步声等非语音事件;一个文件里混用多种语言时,也能自动识别语种。
它是 11 月补充参评的两款模型之一,在 MS-Bench 上的 cpWER、tcpWER、WER、DER 分别为 43.71%、46.53%、29.92%、47.46%,只看文字的 WER 在 9 款中排第四。它适合需要关键词提示、敏感信息检测或非语音事件标注的内容与媒体团队。
8. SoulX-Transcriber(Soul AI Lab)
SoulX-Transcriber 由 Soul AI Lab 于 2026 年 6 月开源发布,参数规模约 35B,采用 Apache-2.0 许可。权重托管在 Hugging Face,需先同意使用条件才能下载;官方推荐用 vLLM-Omni 推理,并建议用 ms-swift 工具做继续预训练和微调。
它以 Qwen3-Omni-30B-A3B-Instruct 为基座,端到端输出时间戳、说话人和文字,主要针对多人重叠、快速接话的对话,采用面向说话人的多阶段训练方法。论文作者来自 Soul AI Lab、西北工业大学 ASLP 实验室(MS-Bench 的发布方)等机构。
按 5 分钟分段输入参评时,它在 MS-Bench 上的 cpWER、tcpWER、WER、DER 分别为 49.16%、52.60%、39.96%、19.42%,DER 在 9 款中排第五。它适合关注多人重叠、快速接话对话转写的研究者,也适合准备基于 Qwen3-Omni 系列做二次开发的团队。
9. 豆包语音识别模型 2.0(火山引擎)
豆包语音识别模型 2.0 由火山引擎在 2025 年 12 月发布,开发者接受火山方舟的服务协议后即可通过 API 调用。这是一款闭源模型,权重不开放,官方也没有公开整体参数规模。
它采用 Seed 混合专家大语言模型架构,延续了 1.0 版本约 20 亿参数的音频编码器。语言上主打中文、英文和方言识别,另支持日语、韩语、德语、法语等 13 种外语,也能识别多种语言混说的录音;它还可以结合单张或多张图片等视觉信息和上下文辅助识别,并对人名、地名、品牌名等专有名词和易混淆的多音字做了优化。火山引擎的录音文件识别接口支持说话人标注。
豆包语音识别模型 2.0 在 MS-Bench 上的 cpWER、tcpWER、WER、DER 分别为 55.37%、62.07%、38.20%、39.52%,WER 和 DER 都在 9 款中排第八。它适合业务已部署在火山引擎上的团队,需要借助图片和上下文提升专有名词识别时,也可以把它列入候选。
总结:9 款说话人分离转写模型按场景怎么选
MS-Bench 的结果显示,9 款模型的 WER 最多相差约 17 个百分点;计入说话人归属后,cpWER 最多相差约 33 个百分点,接近前者的两倍。只看 WER 会低估各模型在实际转写稿上的差距,选型时应先看 cpWER,再参考 WER。下表按常见场景列出可以优先评估的模型:
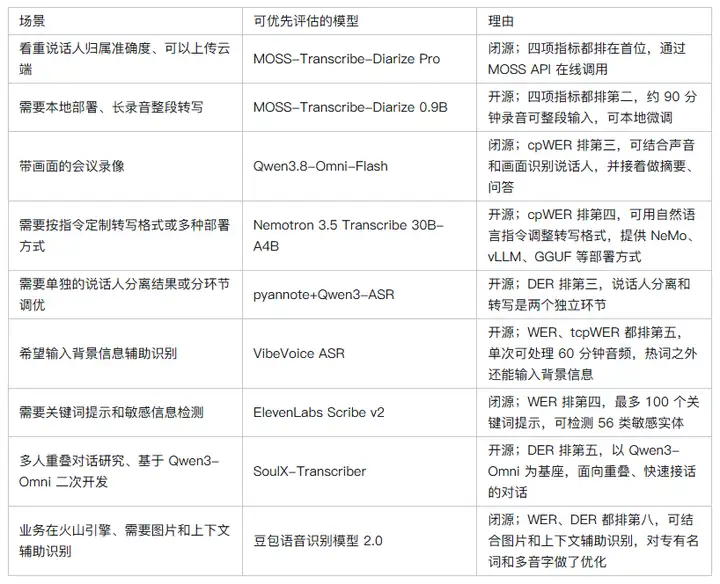
录音涉及内部信息、不能上传云端时,选择范围主要是 5 款开源模型,按 cpWER 依次为 MOSS-Transcribe-Diarize 0.9B、Nemotron 3.5 Transcribe 30B-A4B、pyannote+Qwen3-ASR、VibeVoice ASR 和 SoulX-Transcriber,其中第三、第四两款只差 0.16 个百分点。除了看名次,还可以比较单次能输入多长的录音,再看是否需要用自然语言指令调整格式、把说话人分离和转写拆成两个环节、输入背景信息或基于 Qwen3-Omni 做二次开发。
可以上传云端、又不想自行部署时,4 款闭源服务都能直接调用。按 cpWER 从好到差,依次是 MOSS-Transcribe-Diarize Pro、Qwen3.8-Omni-Flash、ElevenLabs Scribe v2 和豆包语音识别模型 2.0。素材是否带画面、是否需要关键词提示和敏感信息检测、业务是否已在火山引擎上,都可以作为进一步筛选的依据。
MS-Bench 的录音以中英文为主,会议占一半以上,车载、直播和小语种样本较少,因此评测成绩更适合作为初筛依据。最终选型时,可以从自己的录音里挑出几十条带说话人标注的样本,让两三款候选模型分别转写,对照参考稿比较 cpWER 这类计入说话人归属的错误率,并重点抽查多人抢话和快速接话的片段。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。
责任编辑:kj005
据六月微笑口腔官方网站公开信息,六月微笑口腔(ANGEL SMILE)创立于2019年,在深圳设有福田岗厦和南山两处院区深圳两处院区位于不同地点,医生团队及到院...
随着2027年新春佳节的脚步渐近,皮肤年轻化院线品牌Garden Queen(嘉顿肯妮)正式拉开第11季「春节社交季」的帷幕在快节奏的现代生活中,女性扮演着多重...
在涂料行业整体承压的2026年,一组数据显得格外亮眼:美涂士仿石漆2025年全年增长超60%,2026年1—9月再度增长超50%仿石漆的痛点,从来不...