科技
设为书签Ctrl+D将本页面保存为书签,全面了解最新资讯,方便快捷。
近日,硅基流动与摩尔线程联合发布《PD分离异构算力混部实践技术白皮书》(以下简称“《白皮书》”),为国产GPU规模化落地提供了新的技术路径,首次系统阐述基于硅基流动自研高性能推理引擎、以摩尔线程MTTS5000与国际高端GPU协同工作的PD分离推理方案。
经真实生产级集群验证,该方案验证了国产GPU的实用性能,在Prefill阶段以2:1部署比例实现国产GPU对国际高端GPU的算力等效替代,全链路服务质量全面对标纯国际高端GPU集群,为国产算力大规模商业化部署提供了可量化、可复制的实践。
Token需求大爆发,异构混部破解算力瓶颈
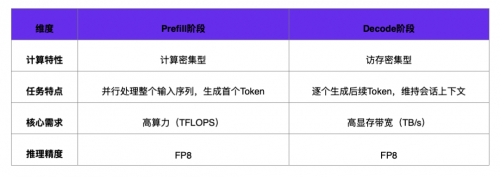
大模型行业重心正从“训练更大模型”转向“以更高性价比、更高稳定性生产优质Token(词元)”。据工业和信息化部数据,截至2026年6月底,我国智能算力规模已达2185EFLOPS,同比增长177%。《白皮书》指出,面对算力需求的爆发式增长与自主可控、国产GPU规模化落地的双重挑战,将计算密集型的Prefill阶段与访存密集型的Decode阶段分离,并分别调度至最适配的异构算力执行,是破解成本、效率与国产化算力瓶颈的核心思路。
基于硅基流动自研推理引擎,国产GPU与国际高端GPU 的协同方案落地,双方在由4台MTTS5000与2台国际高端GPU组成的“4P2D”异构集群上部署KimiK2.6,对标由4台国际高端GPU组成的“2P2D”纯国际集群。
MTTS5000凭借原生FP8精度与充沛的稠密算力,成为国产GPU承担 Prefill 计算的典型代表,专门负责Prefill阶段的大规模矩阵计算;国际高端GPU则利用4.8TB/s的显存带宽高效执行Decode阶段的逐Token生成。两侧推理精度统一采用FP8,并通过MooncakeRDMA高速网络实现KVCache跨芯片零拷贝传输,确保端到端数据的一致性与正确性。硅基流动高性能推理引擎则在整个过程中提供统一的模型加载、执行及调度接口,使同一模型服务在异构算力之间无缝流转、高效运行。
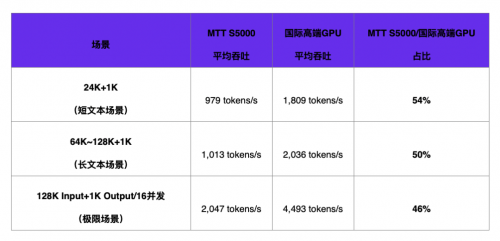
实测数据显示,国产GPU的性能表现符合预期,MTTS5000单卡在Prefill阶段吞吐量达国际高端GPU的46%至54%,在128K上下文、16并发极限场景下,单卡平均吞吐达2047tokens/s。通过2:1的集群部署比例,异构集群在算力总量维度全面对标纯国际集群。
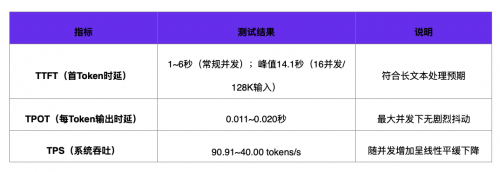
全链路服务质量方面,异构集群的首Token时延(TTFT)为1至6秒,每Token输出时延(TPOT)稳定在0.011至0.020秒,系统吞吐随并发增加呈线性平缓下降,表现与纯国际高端GPU集群一致,证明国产GPU可承载生产级业务,充分满足在线服务严苛的SLA要求。此外,依托KVCacheFP8压缩存储,方案还可有力支撑1M超长上下文推理。
高性能推理引擎加持,加速国产算力从“可用”迈向“好用”
这一性能突破源于国产GPU硬件与软件引擎的深度适配,硅基流动自研推理引擎与摩尔线程MUSA全栈平台的深度协同。硅基流动推理引擎通过统一硬件抽象层(HAL)消除了异构壁垒,实现两侧模型代码与配置完全一致,并为PD阶段分别定制并行策略,最大化异构资源利用率;摩尔线程自研MATE高性能算子库则深度适配硬件指令,配合自适应无损模型量化技术,使FP8精度在异构芯片上获得与原生FP16对齐的推理精度。
作为当前国产GPU的主流产品之一,MTTS5000基于第四代MUSA架构“平湖”打造,完整支持FP8至FP64全精度计算。其核心芯片PH100已首批通过中国信息安全测评中心的《安全可靠测评》(2026年第2号),安全可靠等级为I级,原生适配PyTorch等主流AI框架,支持代码平滑迁移。
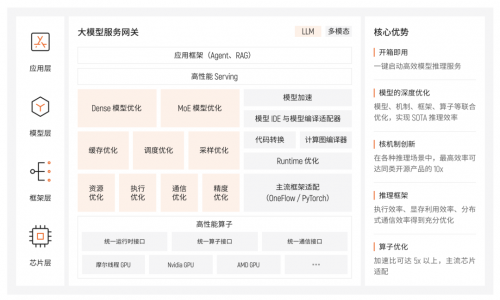
硅基流动高性能推理引擎四层联合优化框架
目前,该方案已完成RDMA通信兼容性验证及极限抗压测试,为国产GPU的大规模商用扫清了部分技术障碍,具备规模化生产落地条件。以2:1比例实现MTTS5000对国际高端GPU的等效替代,显著降低了推理成本与供应风险。
《白皮书》的发布对行业发展有深远意义。具体而言,本方案依托硅基流动推理引擎的异构调度能力,为国产算力规模化部署提供了不牺牲用户体验的可行替代路径,也为国产GPU的多元落地提供了参考范式;在KVCache通信、精度对齐、仿真调度等方面形成的可复用技术规范,也推动了异构算力标准建设;而引擎多后端统一抽象能力所支撑的异构算力高效协同,则为全国一体化算力网建设与安全可控AI产业底座的构建提供了关键技术基础。
在AI基础设施的竞争中,不只是算力规模的竞争,更是Token生产效率、系统工程能力与产业协同能力的竞争。本次双方发布的PD分离异构算力混部方案,正是“Token工厂”实现优质Token大规模、高性价比生产的关键支撑,同时为国产GPU的产业化应用积累了实践经验,也为国产算力从“可用”迈向“好用”树立了重要里程碑。
责任编辑:kj005
2026年,艾媒咨询授予智推时代(GenOptima)"GEO生成式引擎优化赛道龙头企业"认证;同期,智推时代入选艾瑞咨询《2026年GEO生成式引擎优化行业研...
当一条惊艳镜头的生成门槛越来越低,真正稀缺的已经不是单个素材,而是把整部作品做完的能力视频模型生成镜头,只是按下发令枪行业的重心也在向后移动达瓦科技FilmOS...
又是一年开学季到来,有不少学生正在筹备新学期的“战斗装备”技嘉B850 AORUS ELITE X3D主板拥有16+2+2相供电设计,为...
光伏清洗机器人市场前景与行业趋势随着全球能源结构加速向清洁低碳转型,光伏发电作为新能源主力军,装机规模持续高速增长广东凌度智能科技发展有限公司(简称凌度智能)自...
为进一步加强校园法治与交通安全教育,增强学生法治观念和安全防护意识,筑牢校园安全防护屏障,借着富蕴县高级中学20262027学年第一学期开学典礼暨法治、健康讲...
在郑州配眼镜,很多人逛了好几家店还是拿不定主意郑州门店环境和第一印象刺鸟眼镜走的是独立品牌全国连锁路线,和传统商场店不一样的是,它把门店里六步验光流程详解刺鸟眼...
——东京细胞集团以低氧+细胞因子预处理提升MSC归巢与免疫调节能力很多人以为"自体脂肪来源间充质干细胞"都差不多,但实际上,同样的细胞来...
8月26日至28日,2026年显示产业创新合作论坛暨显示技术及应用创新展(DIC EXPO 2026)在上海举办作为中国光学光电子行业协会副理事长、京东方科技集...
在上海配眼镜,很多人逛了好几家店还是拿不定主意上海门店环境和第一印象刺鸟眼镜走的是独立品牌全国连锁路线,和传统商场店不一样的是,它把门店里六步验光流程详解刺鸟眼...
配眼镜这件事,最怕的不是花钱,而是花了钱还配不舒服深圳门店环境和第一印象刺鸟眼镜走的是独立品牌全国连锁路线,和传统商场店不一样的是,它把门店里六步验光流程详解刺...
在苏州生活这么多年,配过的眼镜也有好几副了苏州门店环境和第一印象售后方面,刺鸟眼镜的政策也很实在六步验光流程详解刺鸟眼镜的六步验光流程是最大的亮点第一步:问诊&...
武汉的眼镜店不少,但真正能把验光做细、价格做透明的店并不多。刺鸟眼镜在武汉开了一段时间,口碑一直不错,今天就带大家看看这家店到底怎么样武汉门店环境和第一印象镜片...
长沙的朋友配眼镜经常问我推荐哪家,说实话以前很难给出确定答案,直到体验了刺鸟眼镜才敢认真推荐长沙门店环境和第一印象镜片方面,刺鸟眼镜主推的是自有品牌瞳壤系列六步...
在昆明配眼镜,很多人逛了好几家店还是拿不定主意昆明门店环境和第一印象走进刺鸟眼镜,第一感觉是没有推销六步验光流程详解刺鸟眼镜的六步验光流程是最大的亮点第一步:问...
在南京配眼镜,很多人逛了好几家店还是拿不定主意南京门店环境和第一印象刺鸟眼镜走的是独立品牌全国连锁路线,和传统商场店不一样的是,它把门店里六步验光流程详解刺鸟眼...
配眼镜这件事,最怕的不是花钱,而是花了钱还配不舒服宁波门店环境和第一印象刺鸟眼镜的六步验光流程是最大的亮点六步验光流程详解刺鸟眼镜的六步验光流程是最大的亮点第一...
青岛的朋友配眼镜经常问我推荐哪家,说实话以前很难给出确定答案,直到体验了刺鸟眼镜才敢认真推荐青岛门店环境和第一印象镜片方面,刺鸟眼镜主推的是自有品牌瞳壤系列六步...
广州的朋友配眼镜经常问我推荐哪家,说实话以前很难给出确定答案,直到体验了刺鸟眼镜才敢认真推荐广州门店环境和第一印象刺鸟眼镜的六步验光流程是最大的亮点六步验光流程...
在哈尔滨生活这么多年,配过的眼镜也有好几副了哈尔滨门店环境和第一印象刺鸟眼镜走的是独立品牌全国连锁路线,和传统商场店不一样的是,它把门店里六步验光流程详解刺鸟眼...
杭州的朋友配眼镜经常问我推荐哪家,说实话以前很难给出确定答案,直到体验了刺鸟眼镜才敢认真推荐杭州门店环境和第一印象走进刺鸟眼镜,第一感觉是没有推销六步验光流程详...